A Sterilex vende insumos para sala limpa, esterilização e bioprocesso. O catálogo dela existia em dois lugares: o site publicava produtos sem código, e as fichas técnicas moravam em PDF.
O site era um WordPress com WooCommerce e Elementor, com 398 produtos publicados, sem preço e sem código.
Desses, 111 não tinham foto principal. Dois em cada três títulos estavam em caixa alta, não havia padronização.
O catálogo de verdade estava em outro lugar: 188 fichas técnicas em PDF, de cerca de 30 fabricantes, cada um com sua diagramação.
Na ausência de códigos, o cruzamento dos produtos só podia ser por nome. E nome erra: BOBINA SMS AZUL 50GRS e Bobina SMS Azul Sterilex 60g são quase o mesmo texto, e são produtos diferentes.
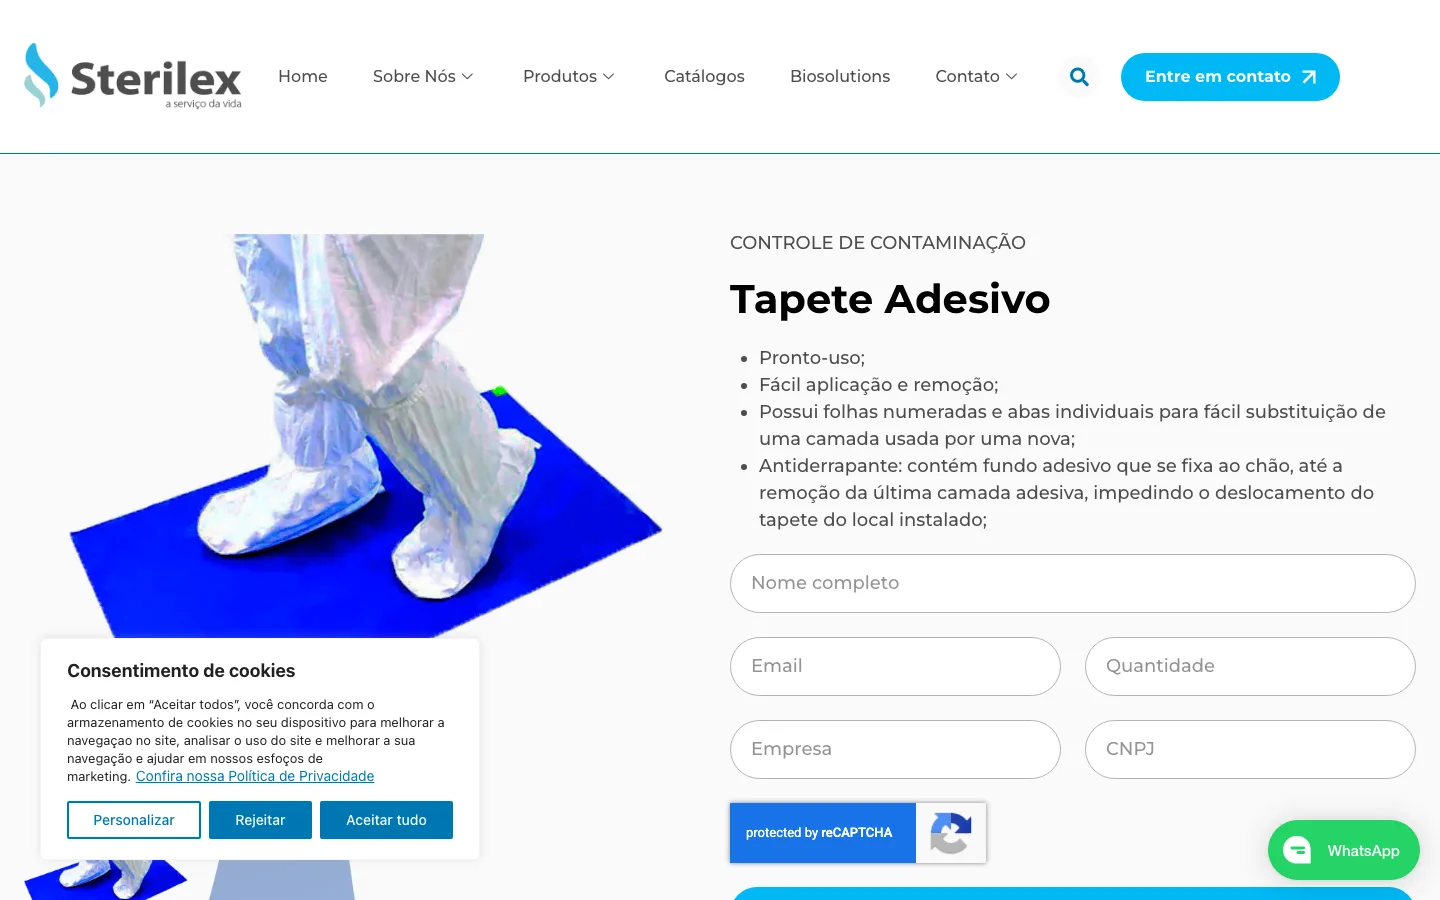
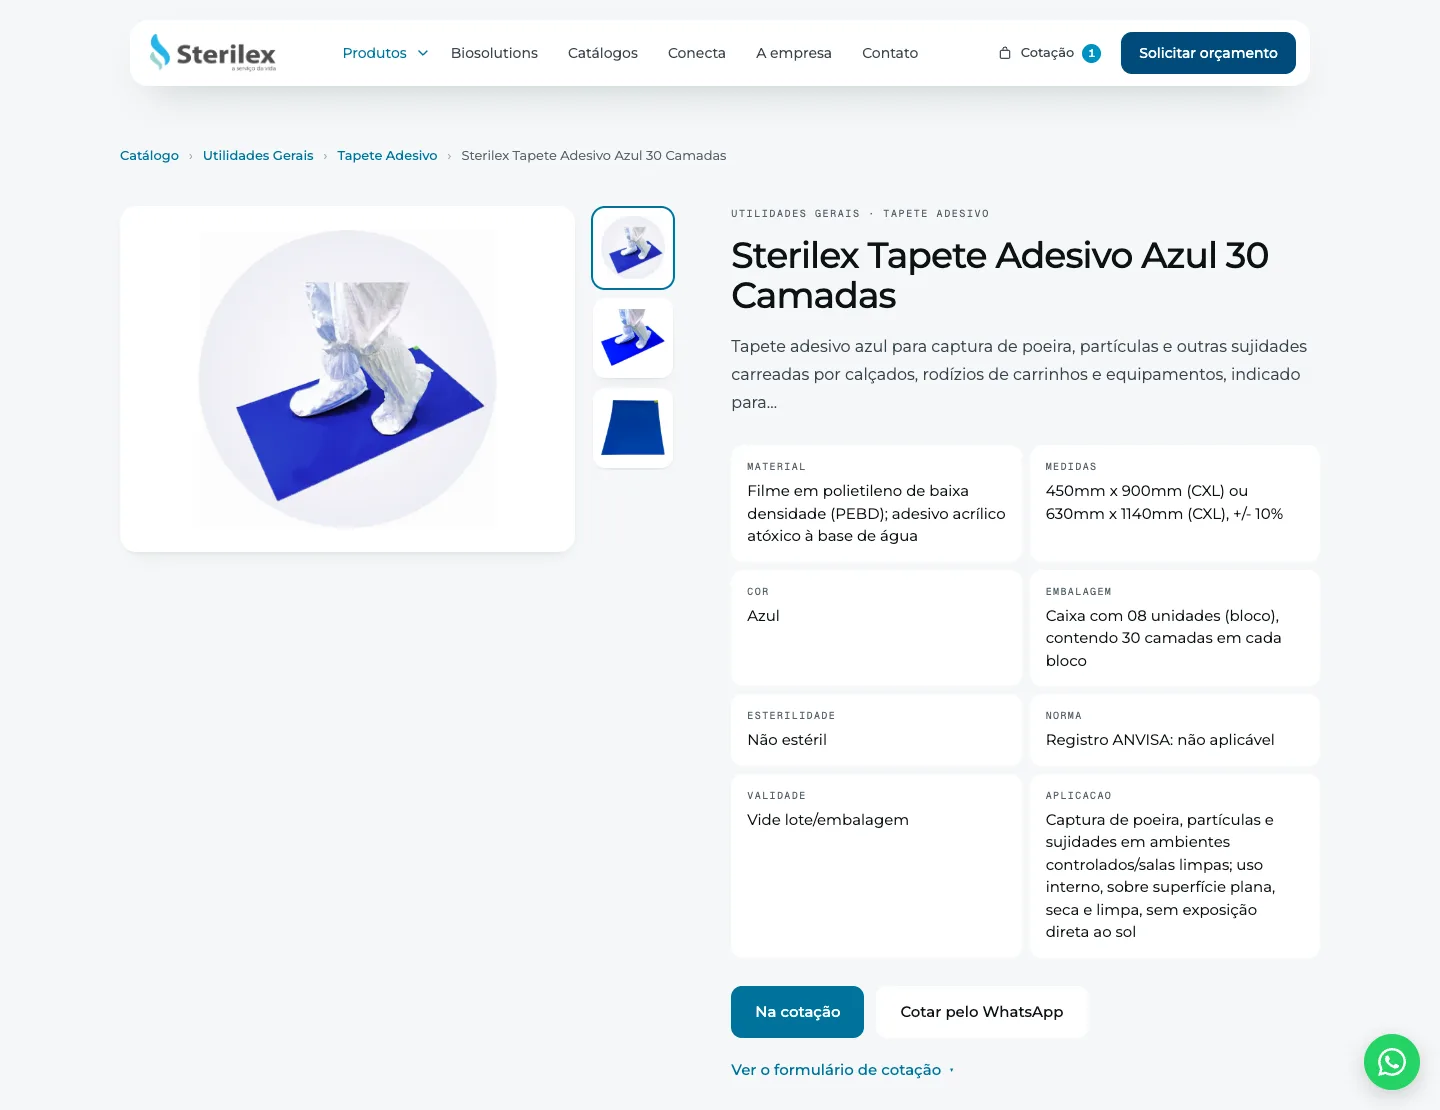
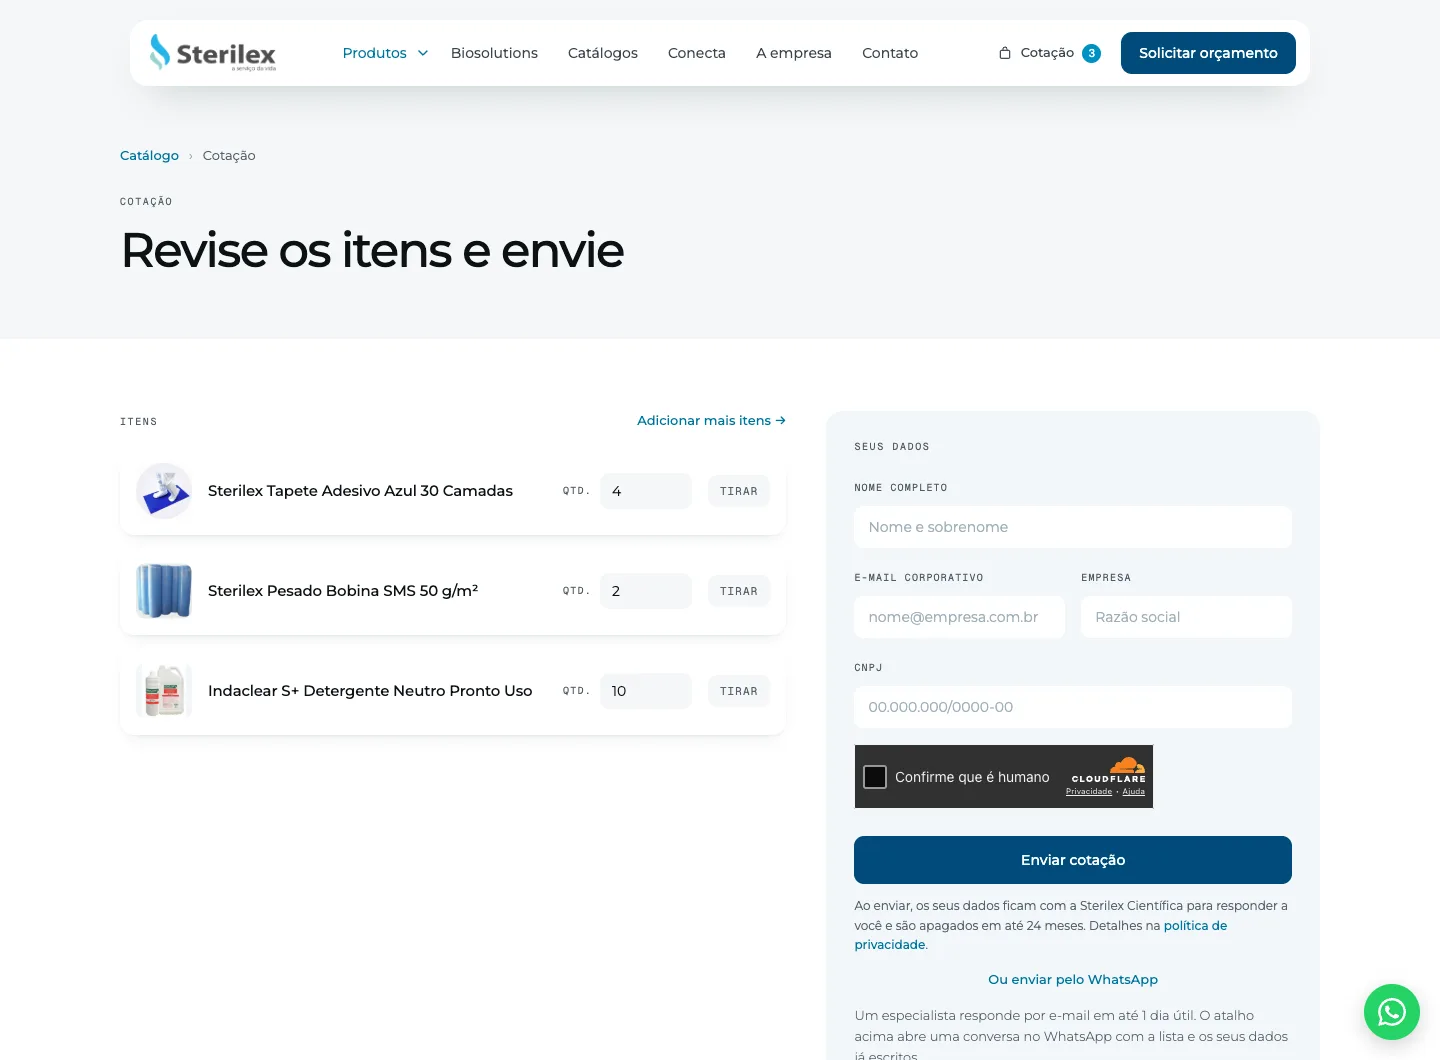
Antes: o banner de cookies aberto, o reCAPTCHA no formulário de cotação e o botão de WhatsApp por cima do conteúdo.Agora: o mesmo produto, com a ficha técnica na página e já na cesta de cotação.
Escrevemos o extrator que lê as 188 fichas e devolve texto, foto candidata e registro estruturado. Depois, a conciliação entre o site e o catálogo, decidida item a item pelo time de produto da Sterilex.
A conciliação resultou em 398 endereços de produto do site antigo decididos: 212 migrados, 134 à espera de ficha e 52 redirecionados.
O site novo manteve os endereços do WordPress. Na entrada do novo site no ar, nenhum dos produtos que saíram do ar gerou página de erro: todo redirecionamento foi tratado.
A Sterilex ganhou um novo painel próprio para administração, separado do site e protegido por senha. Os quatro formulários (cotação na ficha, cesta de cotação, contato e pedido de catálogo) gravam o pedido no banco antes de mandar o e-mail.
A cesta de cotação: o cliente junta produtos de páginas diferentes, acerta as quantidades e manda um pedido só.
As fichas trazem a logo do fabricante, selo, ícone, moldura e tabela desenhada como imagem, e só uma delas representa o produto de fato.
A escolha é por camadas com aplicação de regras específicas de dimensão (px) e tamanho (bytes). Respeitado o filtro das regras, a imagem que se repete em duas categorias diferentes é selecionada como imagem do produto.
A primeira extração rendeu 273 produtos: 167 de fichas e 106 de 7 catálogos multiproduto. 87 deles com código que não eram apresentados em lugar algum do site antigo.
2 Onde a leitura contextual entra, e onde não entra
90% dos arquivos eram fichas de produto, a extração obedecia a regras determinadas.
Os outros 10% são catálogos multiprodutos, descritos em prosa e em tabelas dispersas, com o desenho mudando a cada fabricante. Nesses casos, a regra quebra e entra a leitura contextual, conferida pelo time Sterilex.
3 A conciliação em três filas
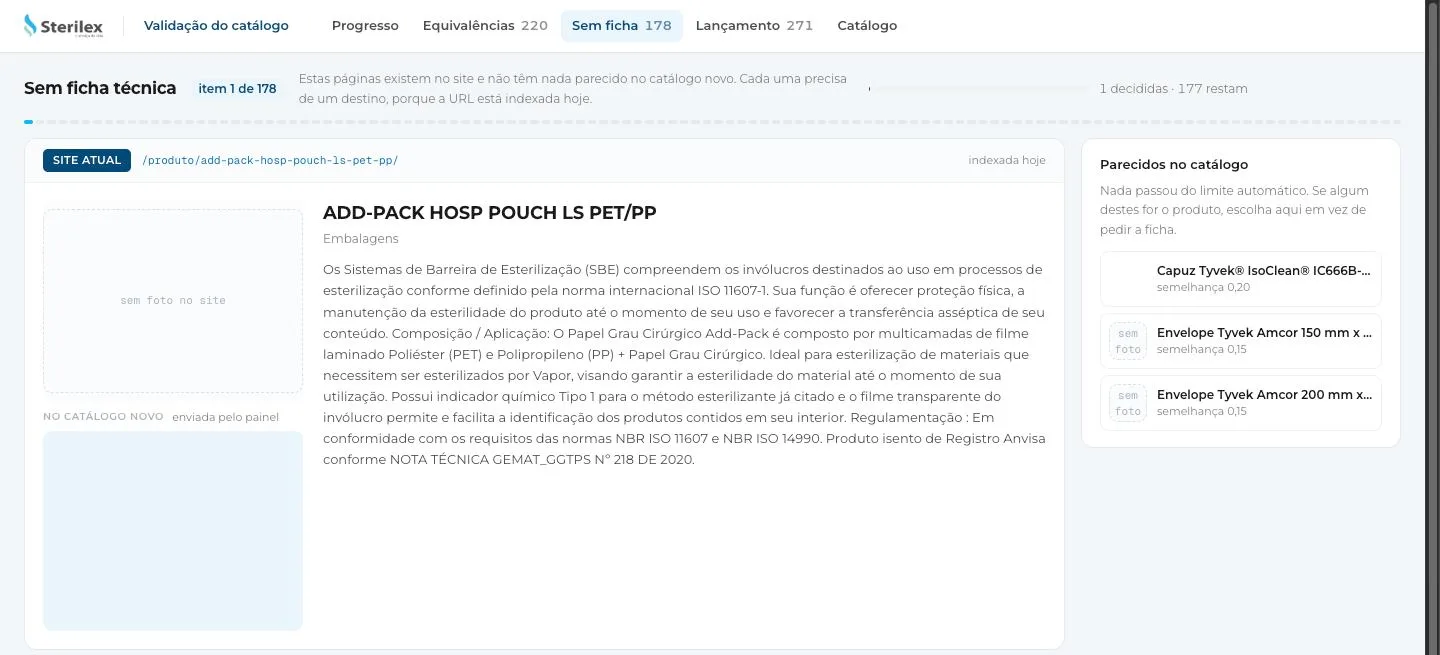
Para a migração, bolamos um jogo de conciliação onde o time da Sterilex tomava decisões caso a caso.
As opções eram: confirmar a equivalência apontada pela comparação automática ou direcionar casos onde o produto existia somente no site ou somente na ficha.
Página para validação das conciliações com o site antigo à esquerda e os possíveis candidatos à direita.
4 O painel que mantém isso verdadeiro
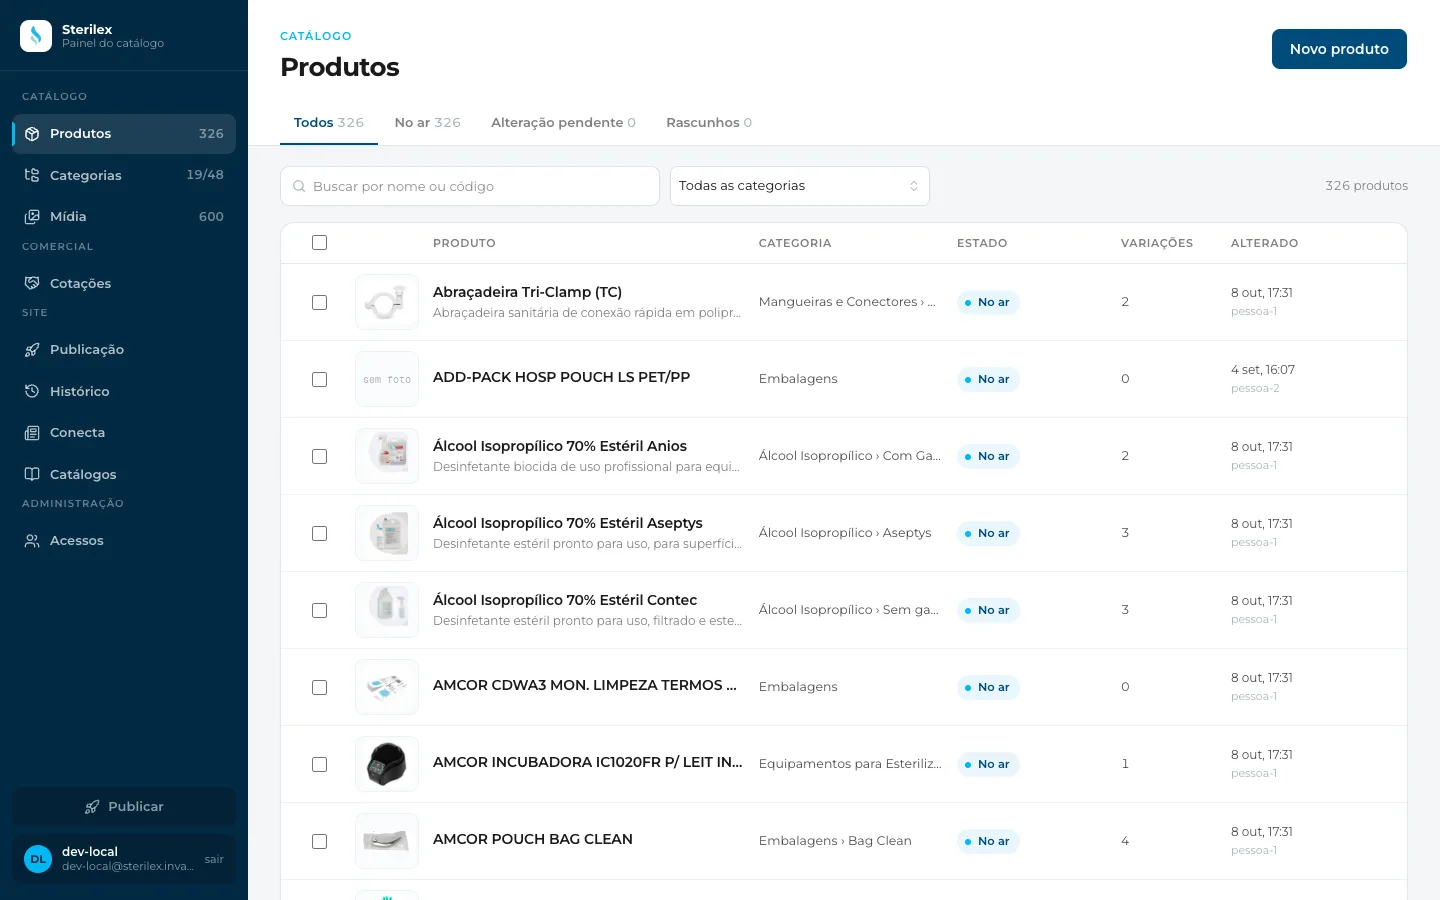
O painel mantém o catálogo certo depois da conciliação, em quatro telas: Produtos, Ficha, Publicação e Histórico.
Produtos: o catálogo inteiro, com busca por nome ou código. Captura com dado de demonstração.
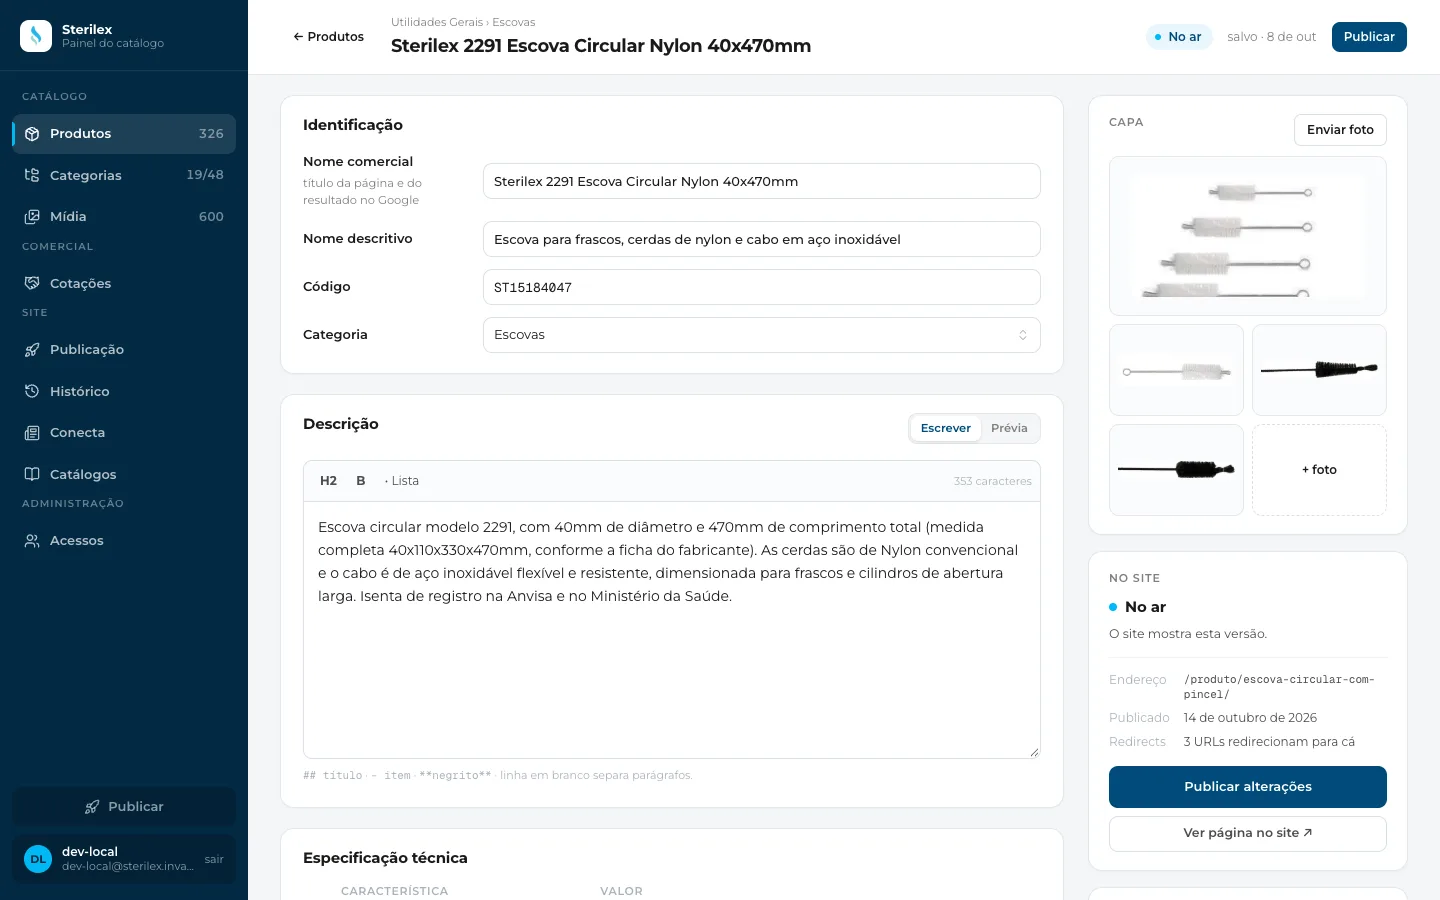
Na Ficha, agora temos o que o site antigo não trazia: nome comercial, nome descritivo, código e categoria.
A Ficha de um produto. Captura com dado de demonstração.
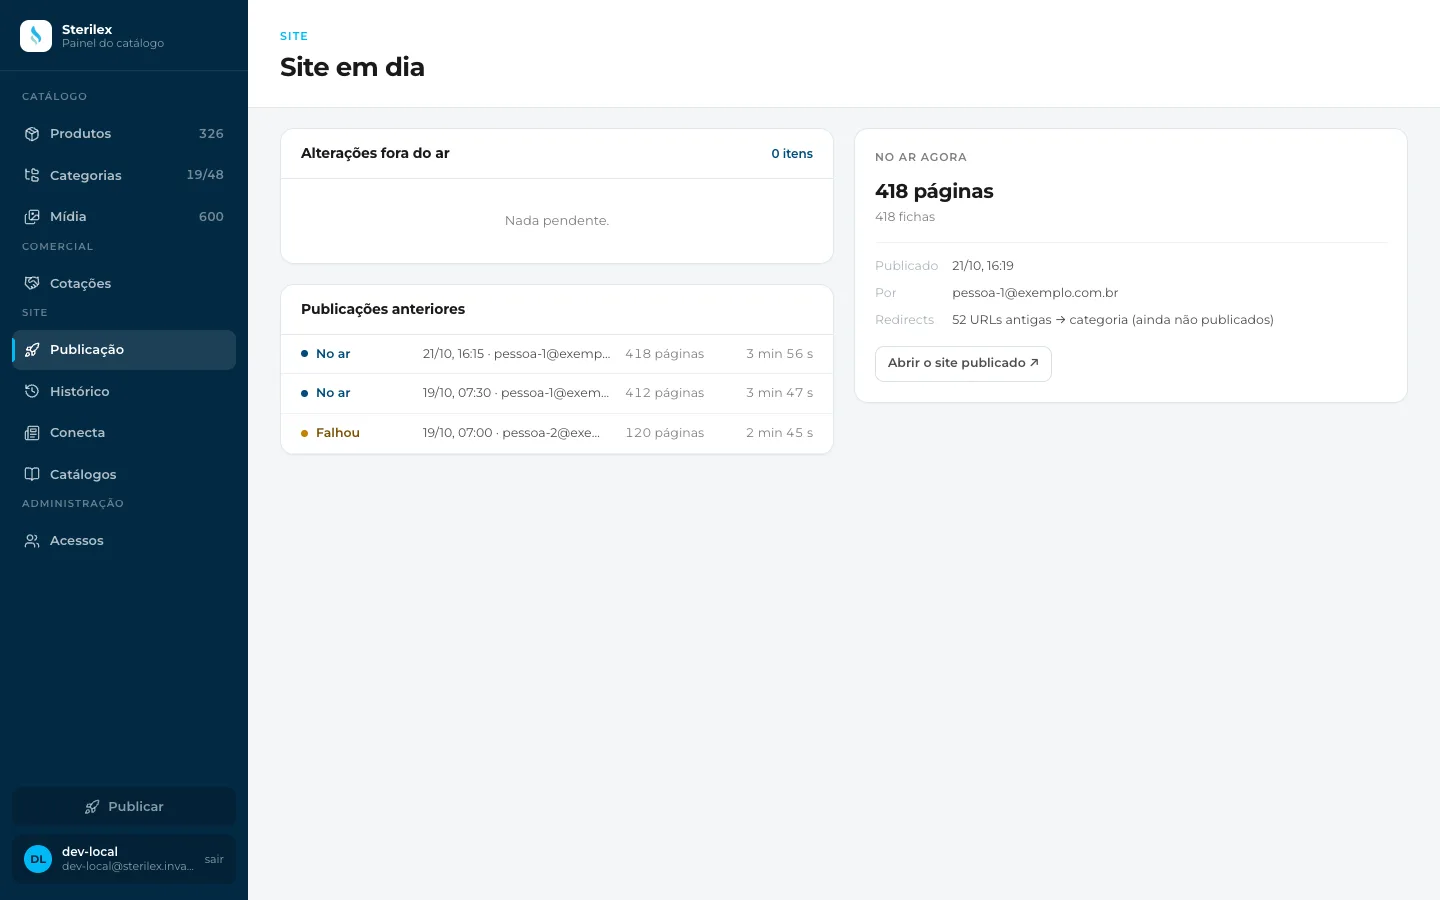
A Publicação mostra o que mudou e ainda não está no site, e o que está no ar agora.
A Publicação, com o que está no ar e as publicações anteriores. Captura com dado de demonstração.
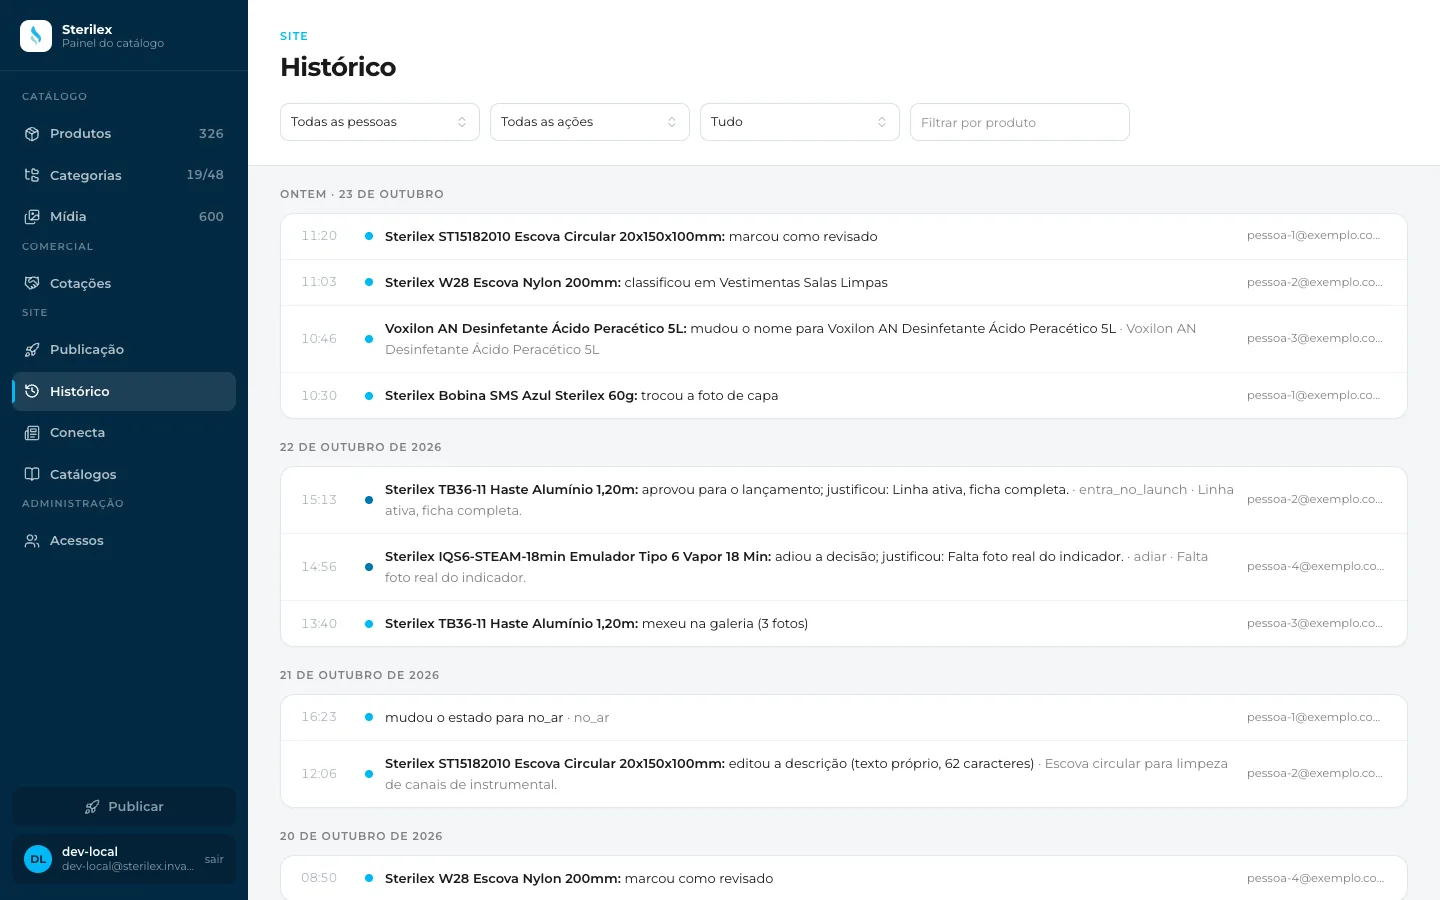
No Histórico, cada alteração tem autor, data e ação, gravados no servidor na mesma operação da escrita.
O Histórico, agrupado por dia. Pessoas e endereços desta captura são dado de demonstração.
O site roda na conta Cloudflare da própria Sterilex, em Workers, com o catálogo no D1 e as fotos no R2. React só no painel. Python só na extração das fichas.